Entretien AI Engineer : expliquer un transformer
Article 2 de la série The AI Engineer Loop — À quoi ressemble un entretien d'AI Engineer en 2026, question par question. Précédemment : les deux questions d'ouverture.
Après le premier appel, l'entretien passe aux fondamentaux. Rassurez-vous : on ne vous demandera pas de dériver la rétropropagation au tableau. On veut savoir si vous connaissez la machine sur laquelle vous construisez, ou seulement son nom.
Deux questions reviennent presque toujours : « Expliquez-moi un transformer » et « Comment fonctionne l'attention ? Qu'est-ce qu'une tête ? » Les deux se traitent en trois minutes. Ce qui fait la différence n'est pas la quantité de détails, c'est la dernière phrase : celle qui relie le mécanisme à quelque chose que vous décidez en production.
Ce que ces questions testent vraiment
Si vous savez ce qu'il y a dans la boîte, ou seulement comment elle s'appelle. Un candidat qui cite « Attention Is All You Need » et s'arrête a prouvé qu'il a lu un titre. Celui qui dit où sont les paramètres et ce que porte le flux résiduel a prouvé qu'il a regardé à l'intérieur.
« Expliquez-moi un transformer. »
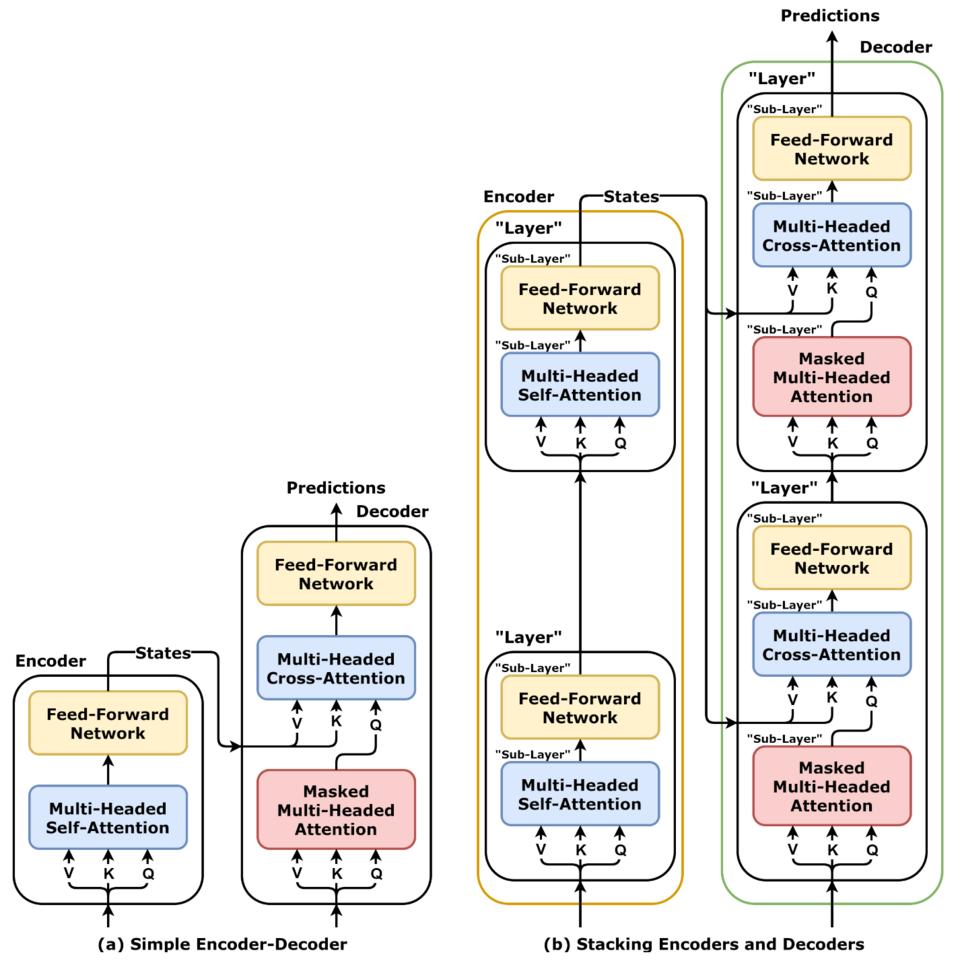
Source : « Transformer, stacked multilayers », dvgodoy (dl-visuals), Wikimedia Commons, licence CC BY 4.0. Rendu PNG de 960 px fourni par Wikimedia, recompressé sans perte (WebP) et hébergé sur viite.ai ; contenu inchangé.

Pas besoin de réciter l'article de 2017. Cinq idées, dans l'ordre :
- Le texte devient des vecteurs. Il est découpé en tokens, chaque token devient un vecteur, et on y ajoute une information de position : l'attention, seule, n'a aucune notion d'ordre.
- Ces vecteurs montent le long d'un flux résiduel, à travers N blocs identiques. Chaque bloc fait deux choses : de l'attention (les tokens s'échangent de l'information), puis un MLP (chaque token est traité indépendamment). Les deux sont entourés de connexions résiduelles et de normalisation.
- En haut, une projection vers la taille du vocabulaire. Elle donne une distribution de probabilité sur le token suivant. C'est tout le modèle : une distribution sur le token suivant, itérée.
- Deux faits à dire à voix haute. L'attention est le seul endroit où les tokens se voient entre eux. Et l'essentiel des paramètres vit dans les MLP (environ les deux tiers pour un modèle de classe 7B, le détail est dans l'article 4) : c'est là qu'on situe, avec prudence, une bonne partie des connaissances factuelles.
- Pourquoi il a battu les RNN. Toutes les positions se calculent en parallèle à l'entraînement, ce qui permet de passer à l'échelle. Mais la génération reste séquentielle, un token après l'autre : c'est pour cela que les tokens de sortie dominent votre latence.
Schéma original, Viite.
Signal d'alarme : citer le papier et s'arrêter. Si vous ne pouvez pas dire où sont les paramètres ni ce que porte le flux résiduel, la récitation ne compte pas.
« Comment fonctionne l'attention ? Qu'est-ce qu'une tête ? »
Ce que la question teste. C'est le seul mécanisme qu'on attend de vous que vous expliquiez de zéro.
- Trois projections. Chaque token se projette en une query, une key et une value. En clair : la query est ce que ce token cherche, la key ce qu'il annonce, la value ce qu'il transmet.
- Scores, échelle, softmax. On note chaque paire par le produit scalaire query·key, on divise par √d_k pour que le softmax ne sature pas, on applique le softmax pour obtenir des poids, puis on fait la somme pondérée des values. La sortie de chaque token est un mélange des tokens auxquels il a prêté attention.
- Une tête, c'est une copie indépendante de ce mécanisme, avec ses propres projections Q/K/V et une dimension plus petite. L'attention multi-têtes en fait tourner plusieurs en parallèle, concatène leurs sorties et reprojette vers la dimension du modèle. Les têtes se spécialisent : certaines suivent la syntaxe, d'autres pointent vers la mention précédente d'un même mot, et les têtes d'induction (copier ce qui a suivi ce motif la dernière fois) comptent parmi les mécanismes derrière l'apprentissage en contexte.
- Le masque causal. Dans un décodeur, les positions futures sont mises à
-infavant le softmax : la position i ne peut jamais voir la position i+1. C'est cette contrainte qui permet d'entraîner la prédiction du token suivant sur toute la séquence en un seul passage. - Le coût. Toutes les paires sont notées : l'attention est en O(n²) de la longueur de séquence. Dites-le tout haut : c'est la raison mécanique pour laquelle le contexte long coûte cher, et le pont entre la théorie et votre budget de latence.
Pour le calcul chiffré, pas à pas : l'attention, calculée à la main. Pour savoir où vivent réellement les matrices : Q, K, V et KV cache : où vivent les poids ?
La phrase à prononcer en entretien
Un transformer, c'est une pile de blocs identiques le long d'un flux résiduel. Chaque bloc alterne de l'attention, où les tokens échangent de l'information, et un MLP, qui traite chaque token seul. À la fin, une distribution sur le token suivant, qu'on itère. L'attention note chaque paire de tokens, donc son coût est en O(n²) : c'est pourquoi je traite la fenêtre de contexte comme un budget que j'alloue plutôt que comme un espace que je remplis.
C'est la dernière proposition qui fait mouche : elle relie le mécanisme à une décision de production, ce qui est la vraie chose testée.
Signal d'alarme : décrire une tête d'attention comme un petit modèle indépendant. Dans un vrai checkpoint, c'est une tranche de colonnes d'une matrice unique par couche, comme le montre l'article 4.
Pour aller plus loin
Si vous préférez voir l'architecture plutôt que la lire :
Vidéo : « Transformers, the tech behind LLMs | Deep Learning Chapter 5 », par 3Blue1Brown — Voir sur YouTube.
Article suivant de la série The AI Engineer Loop : l'attention, calculée à la main, sur une phrase de quatre mots.
Chez Viite, nous simplifions les processus d'entreprise avec l'IA, mais pour l'humain. Nous éditons aussi l'application Business Studio pour gérer vos vies privées ou pros.