« Q, K, V et KV cache : où vivent les poids ? »
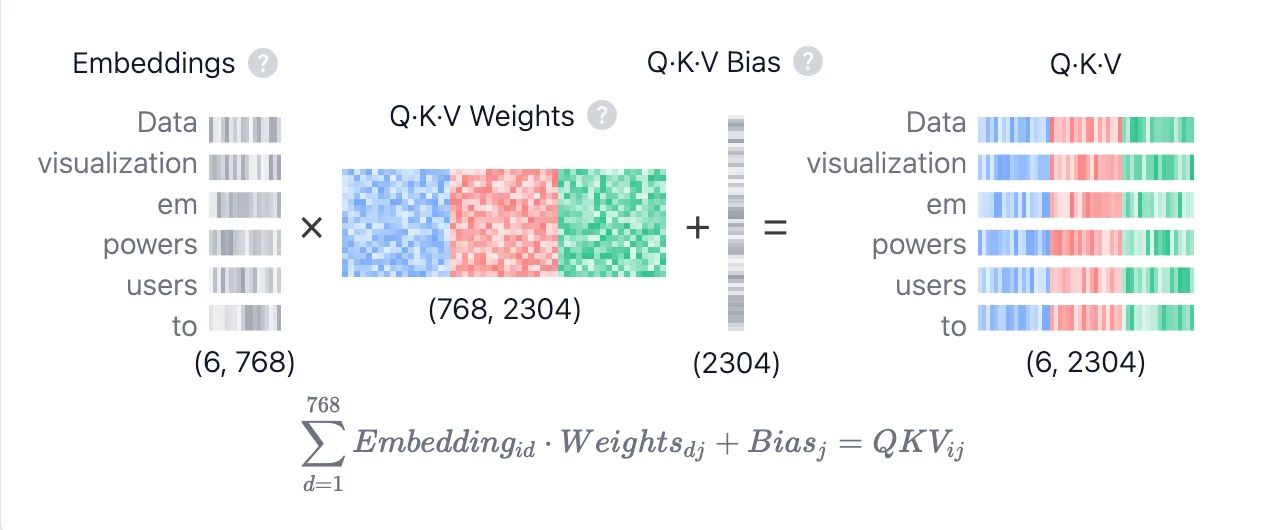
Article 4 de la série The AI Engineer Loop — A quoi ressemble un entretien d'AI Engineer en 2026, question par question. Précédemment : l'attention, calculée à la main.
Dans l'article précédent, nous avons calculé un pas d'attention avec trois matrices W_Q, W_K et W_V de taille 5 × 2. Elles sortaient de nulle part : nous les avions choisies pour que l'arithmétique soit simple.
L'interviewer enchaîne presque toujours avec la même question : « Et dans un vrai modèle, elles sont où, ces matrices ? » Puis, si vous répondez bien, une seconde, plus piégeuse : « Et le KV cache, c'est ça ? »
La réponse à la seconde est non, et c'est la confusion la plus répandue du sujet. Voyons pourquoi.
Ce que la question teste vraiment
Il veut savoir si le schéma du transformer est, pour vous, une image ou un fichier plein de tenseurs.
Un candidat qui n'a jamais ouvert un modèle parle de W_Q comme d'un concept. Un candidat qui l'a fait sait que c'est une ligne dans un fichier, qu'elle a une forme, et qu'il y en a une par couche.
« Où vivent W_Q, W_K et W_V ? »
Elles viennent du checkpoint, le fichier de poids du modèle, juste à côté de tout le reste. Rien dans Q, K et V n'est dynamique ni calculé à la volée : ce sont des matrices apprises lors de l'entrainement, comme les autres.
Voici ce qu'on lit en ouvrant un modèle de la famille Llama au format Hugging Face :
model.embed_tokens.weight               [vocab, d_model]     ← la table d'embeddings
model.layers.0.self_attn.q_proj.weight  [d_model, d_model]   ← W_Q de la couche 0
model.layers.0.self_attn.k_proj.weight  [d_model, d_model]   ← W_K
model.layers.0.self_attn.v_proj.weight  [d_model, d_model]   ← W_V
model.layers.0.self_attn.o_proj.weight  [d_model, d_model]   ← projection de sortie
model.layers.0.mlp.gate_proj.weight     [ffn_dim, d_model]
model.layers.0.mlp.up_proj.weight
model.layers.0.mlp.down_proj.weight
model.layers.0.input_layernorm.weight
model.layers.1.self_attn.q_proj.weight  ← les siennes, sans rapport avec la couche 0
...
lm_head.weight                          [vocab, d_model]     ← la « dé-embedding »
Deux remarques sur cette liste.
Chaque couche a son propre jeu de matrices. Un modèle à 32 couches, c'est 32 W_Q, 32 W_K et 32 W_V indépendants : l'attention de la couche 3 a appris quelque chose de tout à fait différent de celle de la couche 20.
Les formes semblent à l'envers. PyTorch stocke les poids d'une couche nn.Linear en [sortie, entrée], alors que les maths écrivent x × W. Ce n'est pas une erreur, c'est une convention.
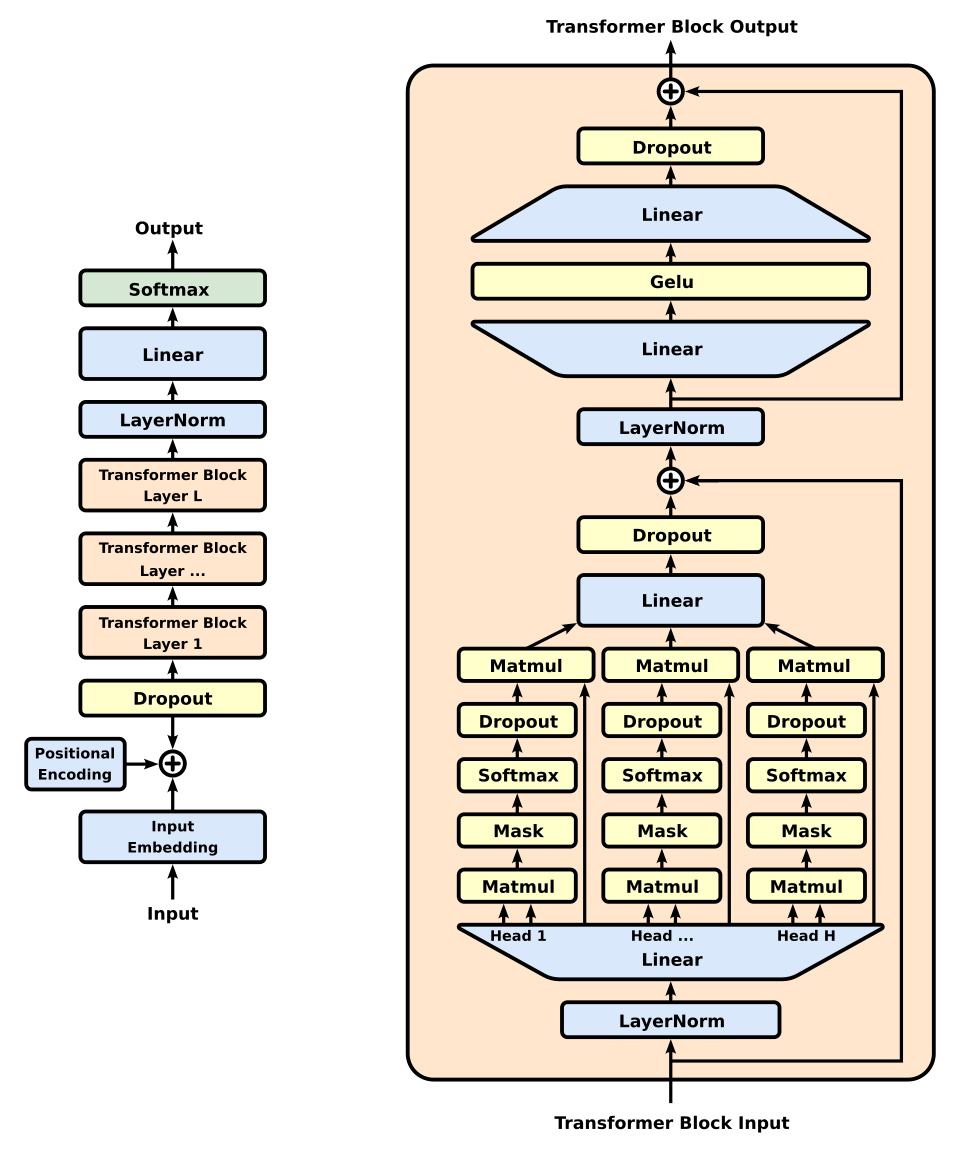
embed_tokens, la pile de blocs à model.layers.N, la couche Linear finale à lm_head. À droite, le détail d'un bloc : une projection Linear qui alimente les têtes d'attention (Q, K, V), la projection de sortie, puis le MLP (Linear, GELU, Linear). Llama remplace GELU par SwiGLU et LayerNorm par RMSNorm ; l'ossature reste la même.Source : « Full GPT architecture », Marxav (original) et Mrmw (vectorisation), Wikimedia Commons, CC0 1.0 (domaine public). Rendu PNG de 960 px fourni par Wikimedia, recompressé sans perte (WebP) et hébergé sur viite.ai ; contenu inchangé.

La table d'embeddings : Il s'agit d'une consultation, pas d'un calcul
embed_tokens.weight a la forme [vocab_size, d_model] : une ligne par token du vocabulaire. Le tokenizer transforme « cat » en un identifiant, par exemple 4832, et le modèle prend la ligne 4832. C'est tout.
Ces lignes sont des paramètres appris comme les autres. Deux mots proches ont des lignes proches uniquement parce qu'ils ont reçu des gradients semblables, ayant servi dans des contextes semblables.
lm_head fait l'inverse en haut de la pile : il projette le dernier vecteur vers [vocab] pour obtenir un score par token. Certains modèles lient les deux matrices et réutilisent le même jeu de poids dans les deux sens.
Les têtes sont des tranches, pas des matrices séparées
Il n'y a qu'un seul W_Q par couche, de largeur n_têtes × d_tête. L'attention multi-têtes est un simple redécoupage de matrice en tranches verticales :
x @ W_Q     →  [seq, 4096]
reshape     →  [seq, 32, 128]      32 têtes de 128 dimensions
                  ↑ la tête 7, ce sont les colonnes 896:1024
Donc « la matrice de requêtes de la tête 7 » est une tranche du W_Q de la couche : un seul produit matriciel, découpé ensuite. C'est pourquoi le multi-têtes ne coûte pas plus cher qu'une tête unique de même largeur totale.
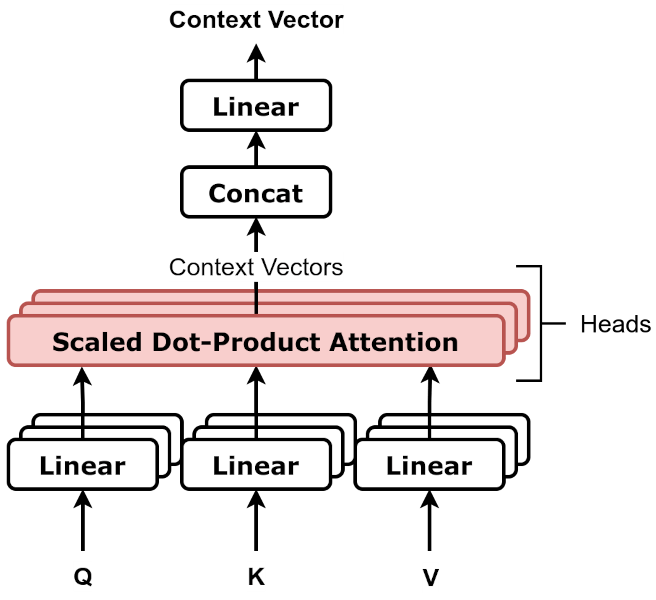
q_proj, k_proj et v_proj), les têtes calculent l'attention en parallèle, leurs sorties sont concaténées puis passent par une dernière couche Linear (o_proj). Les Linear « empilés » du dessin figurent les têtes : dans un vrai modèle, c'est une seule matrice découpée en tranches de colonnes, comme ci-dessus.Source : « Multiheaded attention, block diagram », dvgodoy (dl-visuals), Wikimedia Commons, licence CC BY 4.0. Recompressée sans perte (WebP) et hébergée sur viite.ai ; contenu inchangé.

La variante GQA (grouped-query attention) rend volontairement k_proj et v_proj plus étroites que q_proj : plusieurs têtes de requêtes partagent une même tête de clés et de valeurs. On y reviendra, car cela réduit la taille du KV cache.
D'où elles viennent : de l'entraînement, et de rien d'autre
Initialisation aléatoire, puis descente de gradient sur des milliers de milliards de tokens. Personne ne les dessine.
Les colonnes interprétables de notre exemple — « je cherche un sujet » — étaient imaginées pour simplifier le calcul. Dans un vrai modèle, les dimensions sont entremêlées et aucune ne signifie quoi que ce soit isolément : la structure existe, mais répartie sur des directions de l'espace, pas alignée sur ses axes.
Où sont les paramètres, réellement
Pour un modèle de classe 7B (ces dimensions sont celles de Llama 2 7B : d_model 4096, 32 couches, ffn 11008, vocabulaire de 32 000) :
| par couche | × 32 couches | part | |
|---|---|---|---|
| Q, K, V, O — 4 × 16,8 M | 67,1 M | 2,15 Md | 32 % |
| MLP — gate, up, down | 135,3 M | 4,33 Md | 64 % |
| embed_tokens + lm_head | — | 262 M | 4 % |
| total | 202,4 M | 6,74 Md | « 7B » |
Deux choses sautent aux yeux. L'attention n'est qu'un tiers des poids : la majorité du modèle est ailleurs, dans les MLP. Et la table d'embeddings est minuscule, environ 4 % avec lm_head, alors que c'est la plus grosse matrice prise individuellement (131 M, contre 45 M pour chacune des trois matrices d'un MLP).
Deux confusions que cette question cache
Confusion n° 1 : « les matrices KV » et « le KV cache » sont deux objets différents.
W_KetW_Vsont des poids appris : fixes après l'entraînement, partagés par tous les tokens, toutes les requêtes et tous les utilisateurs. Le KV cache contient des activations calculées pour les tokens d'une séquence : il grandit à chaque token généré et disparaît à la fin de la requête.W_Kdit comment calculer une clé ; le cache, ce sont les clés déjà calculées.
Ordre de grandeur, pour fixer les idées. Sans GQA et en fp16, le cache pèse 2 (K et V) × 32 couches × 4096 × 2 octets, soit 0,5 Mo par token : environ 2 Go pour 4 096 tokens, par requête en cours. Les poids, eux, pèsent un peu plus de 13 Go une seule fois, quel que soit le nombre d'utilisateurs. C'est la raison pour laquelle servir du contexte long est un problème de mémoire, et non de calcul. Le prompt caching des fournisseurs consiste, dans son principe, à conserver ce cache d'une requête à l'autre au lieu de le jeter.
Vidéo : « How LLM Inference Actually Scales: KV Cache, Batching & vLLM », par Codemia — Voir sur YouTube.
Pour le détail de la consommation de mémoire du cache, il y a aussi la vidéo « The KV Cache: Memory Usage in Transformers », par Efficient NLP.
Confusion n° 2, propre au RAG : la table
embed_tokensdu LLM n'a rien à voir avec votre modèle d'embeddings de recherche. Autre modèle, autre objectif d'entraînement, autre espace vectoriel, autre dimension. Et l'un produit un vecteur par token, l'autre un vecteur par passage. Ils ne sont pas comparables, et il n'existe aucun passage d'un espace à l'autre.
« Que fait le MLP ? »
Deux tiers du modèle se trouvent là, et la plupart des candidats ne savent parler que de l'attention.
MLP signifie multi-layer perceptron, l'idée la plus ancienne des réseaux de neurones : des couches linéaires empilées avec une non-linéarité entre elles. Les articles sur les transformers l'appellent aussi FFN (feed-forward network). C'est le même composant sous deux noms.
La phrase à avoir prête : l'attention fait circuler l'information entre les tokens. Le MLP la traite à l'intérieur de chaque token. Il s'applique position par position, avec les mêmes poids, sans aucune communication entre positions : celle-ci a déjà eu lieu dans l'attention.
Élargir, écraser, recontracter
x        [4096]        ← le vecteur d'un token, sorti du flux résiduel
  ↓ projection montante
h        [11008]       ← environ 2,7 fois plus large
  ↓ non-linéarité (GELU / SiLU)
  ↓ projection descendante
out      [4096]        ← rajouté dans le flux résiduel
L'élargissement est le point : on projette dans un espace bien plus grand, où les caractéristiques se séparent proprement, on applique la non-linéarité, puis on recompresse vers d_model.
Pourquoi la non-linéarité est indispensable : deux couches linéaires empilées valent mathématiquement une seule couche linéaire, (xA)B = x(AB). Sans quelque chose de non linéaire entre elles, les 32 couches s'effondreraient en une seule matrice. C'est la non-linéarité qui donne un sens à la profondeur.
Pourquoi le checkpoint listait trois matrices
La version classique en compte deux : une montante, une descendante. Les modèles récents utilisent SwiGLU, qui en compte trois :
out = (SiLU(x @ W_gate) * (x @ W_up)) @ W_down
Deux projections montantes : l'une devient une porte (passée dans SiLU, elle règle combien laisser passer, neurone par neurone), l'autre porte le contenu. On multiplie terme à terme, puis on redescend. C'est un bouton de volume appris pour chaque neurone, et il donne de meilleurs résultats que la version simple à nombre de paramètres égal.
Cela explique aussi l'étrange 11008. Pour garder trois matrices au coût approximatif de deux, on réduit la largeur de deux tiers : 4 × 4096 × 2/3 = 10 922,7, arrondi au multiple de 256 supérieur, soit 11008.
Pourquoi on dit que « les connaissances vivent là »
C'est une interprétation, pas un fait établi, mais c'est la plus répandue. Les travaux de Geva et al. (2021) lisent le MLP comme une mémoire clé-valeur :
- la projection montante donne 11008 neurones, chacun s'activant sur un motif du vecteur entrant — des détecteurs ;
- la projection descendante enregistre ce qu'il faut écrire en retour quand ce neurone s'active.
Schématiquement : un neurone s'active quand le contexte parle de Paris, et la projection descendante pousse alors le flux résiduel vers des tokens liés à la France. Ce serait le mécanisme derrière « les faits vivent dans les MLP », et la raison pour laquelle les travaux d'édition de modèles, comme ROME (Meng et al., 2022), qui font croire à un modèle que la tour Eiffel est à Rome, visent les poids des MLP plutôt que l'attention.
Vidéo : « How might LLMs store facts | Deep Learning Chapter 7 », par 3Blue1Brown — Voir sur YouTube.
Retenez le chiffre qui reste en tête : deux tiers d'un transformer, c'est du MLP. L'attention récolte toute l'attention, parce que c'est le mécanisme intéressant, celui du titre de l'article fondateur et celui dont on parle en entretien. Mais en nombre de paramètres, le modèle est surtout une très large pile de réseaux feed-forward appliqués position par position.
La phrase à prononcer en entretien
W_Q,W_KetW_Vsont des matrices apprises, stockées dans le checkpoint : une par couche, avec les têtes découpées en tranches de colonnes. Elles pèsent environ un tiers des paramètres ; les deux tiers restants sont dans les MLP. Le KV cache, lui, n'est pas un poids : ce sont des activations calculées pour une séquence, qui grandissent avec elle. C'est ce qui rend le contexte long coûteux en mémoire, et ce qu'on réutilise quand on fait du prompt caching.
Signal d'alarme : parler de « matrices KV » pour désigner le cache, ou répondre que les poids de Q, K et V sont recalculés pour chaque requête. Ils ne le sont jamais : ce qui change d'une requête à l'autre, ce sont les activations, pas les poids.
Article suivant de la série The AI Engineer Loop : encodeur, décodeur, embeddings et tokenisation — et pourquoi votre modèle d'embeddings de recherche n'est pas celui de votre LLM.
Chez Viite, nous simplifions les processus d'entreprise avec l'IA, mais pour l'humain. Nous éditons aussi l'application Business Studio pour gérer vos vies privées ou pros.